PG关注到,研华8月31日发布WEDA平台指南,介绍集中协调与设备侧执行的分工。WEDA Core管理设备、容器应用和模型部署,WEDA Node承担现场工作负载与状态回报;本文围绕这种架构观察分布式应用的日常运行。
当应用从一台设备扩展到多个地点,管理者需要回答的不只是怎样安装,还包括每台设备当前执行什么、配置是否生效,以及异常时由谁接手。平台的实用性因此需要通过持续记录体现。
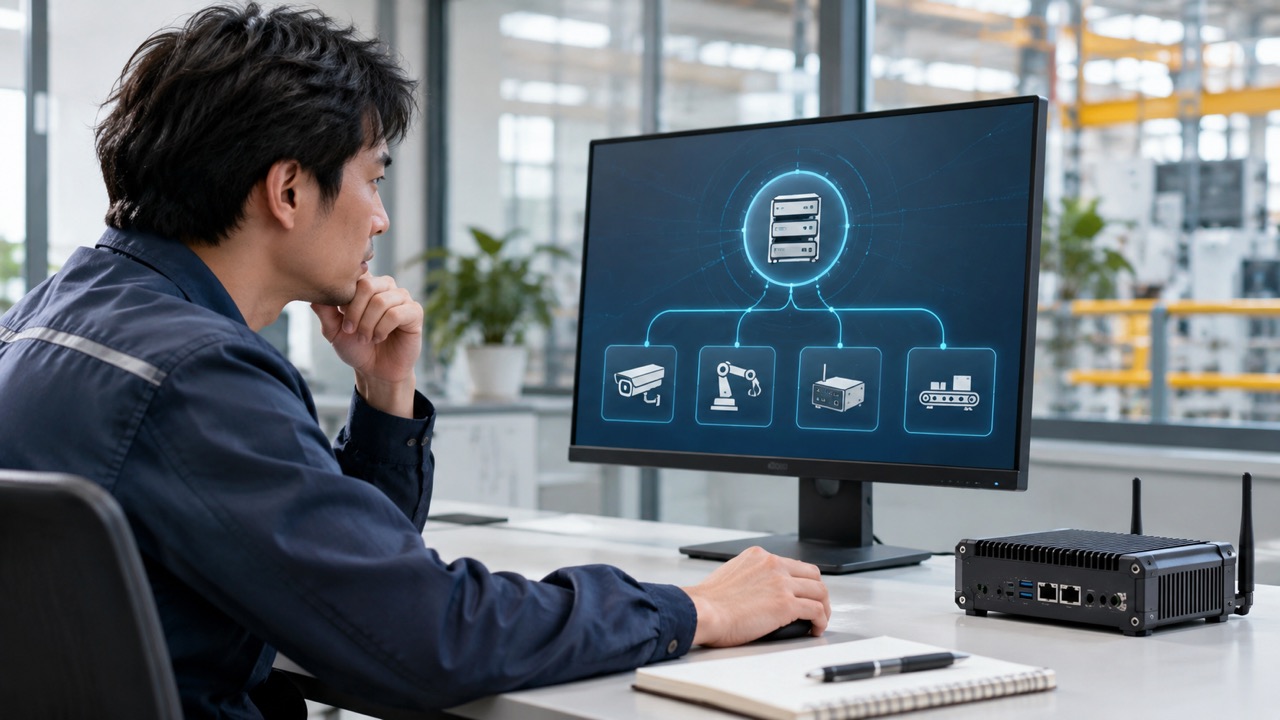
集中分配与现场执行是不同状态
官网说明WEDA可管理兼容设备的容器与批准模型文件,客户继续使用自己的开发工具和应用。它不自动提供每个行业的算法,也不将交通控制等领域动作变成平台默认能力,具体整合仍属于完整方案。
独立观察认为,中心分配了一个版本,并不表示现场已经采用它。设备收到任务、下载资料、启动应用和持续执行,属于不同阶段,管理界面应能解释这些区别,避免一个成功标签掩盖等待。
状态记录还要关联设备与任务。设备在线只能说明某条管理连接可用,不能直接证明输入、模型与后续输出正常;若各层缺少关联,团队就容易误判恢复情况。
容器复用需要清楚硬件适用范围
准备好的开发环境可以提供共同起点,但具体硬件、操作系统和加速资源仍需符合支持条件。相同应用包在不同设备上如何执行,应通过实际任务核查,而不是依据容器形式自动认定一致。
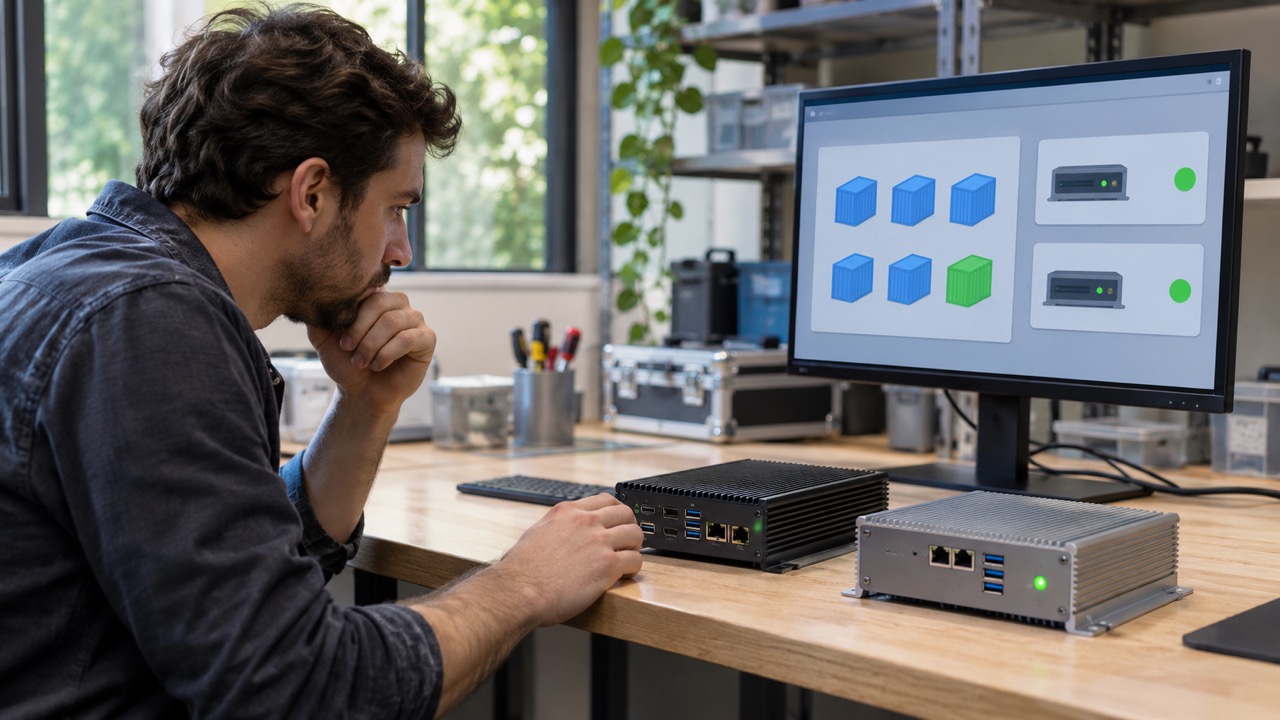
从独立工程分析看,交付资料应列明依赖和版本。模型、驱动与输入处理之间的关系如果只保存在开发者记忆中,后续维护就难以复现问题;文件可以复制,隐含条件却不会自动随之传递。
版本更新后,输出含义也可能需要复查。不同模型的分数或类别未必完全一致,下游应用若继续采用旧解释,就可能产生新的整合问题,因此发布应覆盖完整业务链路。
断连与恢复需要说明任务边界
指南指出,按既有配置设计的本地工作负载可以在连接中断时继续运行,而需要集中协调的变化等待网络恢复。这一描述有明确条件,不能扩大为任何应用都可无限期离线。
现场需要知道哪些记录尚未同步,中心也要能够识别最后一次有效状态。连接恢复后,延后数据应保留原始时间,避免与当前事件混用,让团队准确理解发生过什么。
扩大部署时还应保留地点差异。各节点的传感器、外设与网络可能不同,统一管理需要把这些条件纳入资产资料;否则,同一版本在不同地点的行为差异就难以解释。
项目周期与许可条件也不能由一篇平台介绍统一确定。文章本身明确部署时间取决于模型、硬件与整合范围,商业选项需要按具体项目确认,本文不将其改写成固定上线期限或成本承诺。
交接时可围绕代表性任务保存检查结果:中心配置、现场执行、输出接收和恢复状态分别怎样确认。这样的资料能够让新团队继续维护,而不只依靠最初部署人员的经验。
对未完成的部署,也应保留原因和当前阶段。这样,维护人员能够区分等待连接、配置尚未生效与应用异常,避免对所有节点采用同一种恢复操作。
在PG看来,WEDA的架构价值是为分布式设备与应用提供共同管理流程。把分配、生效和持续运行分开记录,保留客户应用与现场条件的边界,才能准确评价平台在真实任务中的作用。